05 · Server, Virtualisierung & Cloud
AP2Das Herz der AP2-Bereiche „Konzeption und Administration von IT-Systemen“. RAID-Rechnungen und Virtualisierungs-Abwägungen sind Standardaufgaben.
05.1 · Virtualisierung: Hypervisor & Container
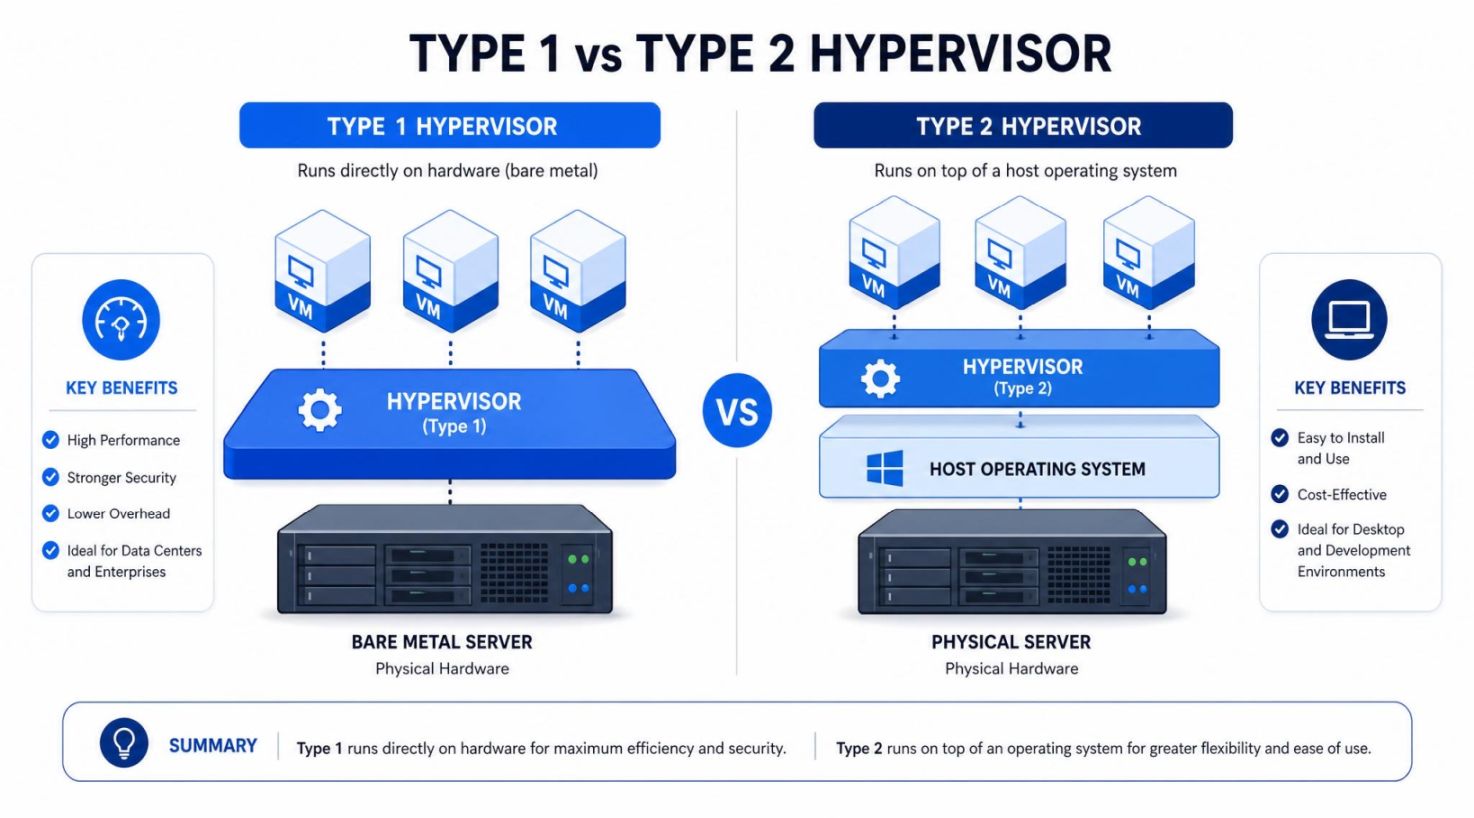
AP2regelmäßigVirtualisierung und Container erlauben es, mehrere isolierte Umgebungen auf derselben physischen Hardware zu betreiben – sie unterscheiden sich vor allem darin, wie viel vom Betriebssystem sie mitbringen und wie stark sie voneinander abgeschottet sind.
| Typ 1 (bare metal) | Typ 2 (hosted) | Container | |
|---|---|---|---|
| läuft auf | direkt auf Hardware | als Programm im Host-BS | im Kernel des Host-BS |
| Beispiele | ESXi, Hyper-V, Proxmox | VirtualBox, VMware Workstation | Docker, Podman, LXC |
| Gast | vollständige VM, eigenes BS | nur App + Bibliotheken, teilt den Kernel | |
| Stärke | Produktion, Performance | Test/Entwicklung | leichtgewichtig, startet in Sekunden, portabel |
Warum virtualisieren? Serverkonsolidierung (bessere Auslastung, weniger Blech, Strom, Platz), Snapshots vor Updates, einfache Wiederherstellung, Live-Migration, Testumgebungen. Grenzen von Containern: gemeinsamer Kernel → schwächere Isolation als VMs, kein anderes Gast-BS.
Begründungsaufgabe-Klassiker: „VM oder Container für Dienst X?“ – Ganzes fremdes BS oder starke Isolation nötig → VM. Gleiche Plattform, viele kleine Dienste, schnelle Deployments → Container. (Dein NAS macht beides.)
Grafik in voller Größe öffnen ↗
05.2 · Cloud-Modelle
AP1, AP2regelmäßigCloud-Angebote unterscheiden sich darin, wie viel Verwaltung der Anbieter übernimmt und wie viel beim Kunden bleibt – von der reinen Infrastruktur bis zur fertigen Anwendung.
| Modell | Anbieter liefert | Du verwaltest | Beispiel |
|---|---|---|---|
| IaaS | Rechenleistung, Speicher, Netz | BS, Middleware, App | EC2, Azure VM |
| PaaS | + Laufzeitumgebung | nur die Anwendung | App-Hosting, Managed DB |
| SaaS | fertige Anwendung | nur Konfiguration | Microsoft 365, Webmail |
Bereitstellung: Public (geteilte Anbieter-Infrastruktur), Private (eigene, exklusiv – auch on-prem), Hybrid (Kombination, z. B. Backup in die Cloud), Community. Shared Responsibility: der Anbieter sichert die Cloud, der Kunde seine Daten, Konten und Konfiguration.
Abwägung Cloud vs. On-Premises (beliebte Konzeptaufgabe): Skalierbarkeit, keine Anfangsinvestition (OpEx statt CapEx), Verfügbarkeit und Wartung durch Anbieter – gegen laufende Kosten, Datenschutz/Datenstandort (DSGVO!), Internetabhängigkeit, Vendor-Lock-in.
05.3 · RAID – mit Rechenweg
AP2HäufigRAID verteilt Daten über mehrere Festplatten, um Ausfallsicherheit, Tempo oder beides zu gewinnen – je nach Level auf Kosten unterschiedlich viel nutzbarer Kapazität.
| Level | Prinzip | min. | Netto | Ausfälle | Einsatz |
|---|---|---|---|---|---|
| RAID 0 | Striping | 2 | 100 % | keinen | nur Tempo |
| RAID 1 | Spiegelung | 2 | 50 % | 1 | Systemplatten |
| RAID 5 | + 1× Parität | 3 | (n−1)/n | 1 | Standard-Datengrab |
| RAID 6 | + 2× Parität | 4 | (n−2)/n | 2 | große Arrays |
| RAID 10 | Spiegel + Striping | 4 | 50 % | 1 je Paar | DB, schnell + sicher |
RAID 0: nie für wichtige Daten. RAID 6: großer Rebuild-Aufwand.
05.4 · Storage-Architekturen: DAS, NAS, SAN
AP2regelmäßigDAS, NAS und SAN unterscheiden sich darin, wie ein Server auf seinen Speicher zugreift – direkt angeschlossen, über das normale Netzwerk oder über ein eigenes Speichernetz.
| DAS | NAS | SAN | |
|---|---|---|---|
| Anbindung | direkt am Server | über LAN | eigenes Speichernetz |
| Zugriff | Blockebene | Dateiebene (SMB/NFS) | Blockebene (LUN) |
| Einsatz | Einzelserver | zentrale Ablage, Teams | Virtualisierung, DB, RZ |
DAS: SATA/SAS/USB. SAN: iSCSI oder Fibre Channel; der Server sieht die LUN wie eine eigene Platte.
Ergänzend: LTO-Bandlaufwerke für Langzeitarchiv und Offline-Kopien (ransomware-sicher, „Air Gap“), Objektspeicher (S3) in der Cloud. Prüfungsfrage gern: „Warum SAN für den Virtualisierungscluster?“ → Blockzugriff, zentral, schnell, Voraussetzung für Live-Migration.
05.5 · Backup-Strategien
AP1, AP2HäufigWie viel eine Sicherung kostet und wie aufwendig die Wiederherstellung ist, hängt von der gewählten Sicherungsart ab – Voll-, differenzielle und inkrementelle Sicherung unterscheiden sich genau darin.
| Art | sichert | Platz/Tempo | Wiederherstellung |
|---|---|---|---|
| Vollsicherung | alles | groß / langsam | 1 Satz |
| Differenziell | alles seit der letzten Vollsicherung | wächst über die Woche | Voll + Differenz (2 Sätze) |
| Inkrementell | alles seit der letzten Sicherung | klein / schnell | Voll + Inkremente (Kette!) |
- 3-2-1-Regel: 3 Kopien, 2 verschiedene Medientypen, 1 Kopie außer Haus (oder offline/immutable – Ransomware!).
- Generationenprinzip (Großvater–Vater–Sohn): Tages-, Wochen-, Monatsstände rotieren → mehrere Zeitpunkte wiederherstellbar.
- RPO = maximal tolerierter Datenverlust (Zeit seit letzter Sicherung), RTO = maximale Wiederanlaufzeit. Und: Restore regelmäßig testen – ein ungetestetes Backup ist ein Gerücht.
05.6 · Hochverfügbarkeit & Monitoring
AP2regelmäßigHochverfügbarkeit bedeutet, Ausfälle durch Redundanz gar nicht erst zu einem Problem werden zu lassen – wie viel Ausfallzeit dabei noch toleriert wird, gibt die Verfügbarkeit in Prozent an.
- SPOF (Single Point of Failure) identifizieren und beseitigen:
- doppelte Netzteile
- RAID
- zwei Switches (Link Aggregation)
- USV + Notstrom
- Server-Cluster mit Failover
- zweiter Standort
- Cluster: aktiv/passiv (Standby übernimmt) vs. aktiv/aktiv (Lastverteilung). Heartbeat überwacht die Knoten.
- Monitoring: SNMP (Abfrage von Geräten, Traps als Alarme), Syslog (zentrale Logs), Checks auf Dienste, Platz, Temperatur; Tools wie Zabbix, CheckMK, PRTG. Erst messen, dann alarmieren, dann eskalieren.
05.7 · Eigene Notizen
ungeprüftPlatz für das, was in Unterricht und Praktikum dazukommt. Abschnitt kopieren, Inhalt eintragen, später das Belegzeichen austauschen – System siehe Legende.